Die Technik im Detail
Wie der Listener erkennt, wer spricht, und woher die Stimme kommt: das neuronale Netzwerk Schicht für Schicht und die Richtungsberechnung mit vier Mikrofonen. Beschrieben ist der Stand des Prototyps.
Den Überblick ohne Technik gibt es auf der Seite Funktionen.
Der Signalweg
1Vier Mikrofone
Vier digitale Mikrofone liefern Tonwerte. Sie teilen sich denselben Takt und werden im selben Augenblick abgetastet. Das ist die Grundlage für die Laufzeitmessung.
2Vorverarbeitung
Filter entfernen Gleichanteile und lernen das Hintergrundgeräusch. Eine Spracherkennung entscheidet, ob gerade gesprochen wird. Nur Abschnitte mit Sprache gehen weiter.
3Richtung
Aus den Laufzeitunterschieden zwischen den Mikrofonpaaren wird der Winkel berechnet, aus dem gesprochen wird. Er erscheint im Sitzplan. Das Prinzip steht weiter unten im Abschnitt „Die Richtung mit vier Mikrofonen“.
4Spektrogramm
Ein Ausschnitt von etwa 2 Sekunden wird in ein Bild umgerechnet. Es zeigt, welche Frequenzen wann wie stark sind.
5Neuronales Netzwerk
Das Netzwerk macht aus dem Bild einen Fingerabdruck der Stimme: eine kurze Zahlenreihe. Dieselbe Stimme ergibt ähnliche Zahlen, verschiedene Stimmen unterschiedliche. Auf dem Chip dauert das nur Bruchteile einer Sekunde.
6Zuordnung
Der Fingerabdruck wird mit allen angelernten Stimmprofilen verglichen. Passt keines ausreichend gut, zählt die Äußerung als „Unbekannt“. Die Dauer wird der erkannten Person gutgeschrieben.
Alles läuft im Gerät auf einem ESP32-P4, ohne Cloud. Das Netzwerk wird mit ESP-DL ausgeführt, der Deep-Learning-Bibliothek von Espressif.
Das neuronale Netzwerk
Das Netzwerk hört nicht auf Wörter. Es bekommt ein Bild des Klangs, ein Spektrogramm, und beschreibt damit die Stimme: Welche Frequenzbereiche sind wie stark, und wie verändert sich das über zwei Sekunden? Dieselbe Person ergibt ähnliche Zahlen, verschiedene Personen ergeben unterschiedliche.
Eingabe: das Spektrogramm
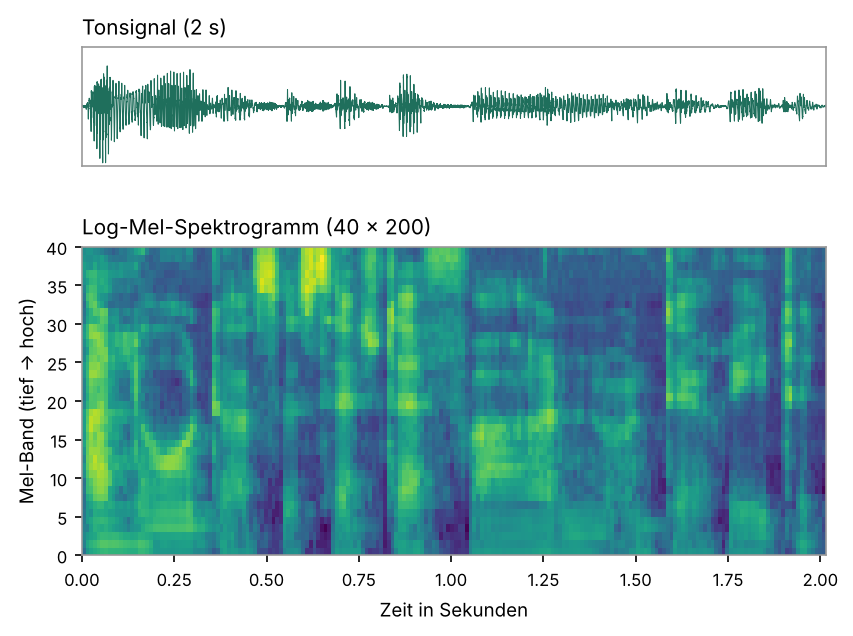
So entsteht das Bild
- Die Höhen des Tonsignals werden leicht angehoben.
- Der Ton wird in sehr kurze, überlappende Fenster geschnitten.
- Pro Fenster wird gemessen, wie stark die einzelnen Frequenzbereiche sind, in Stufen, die dem menschlichen Gehör folgen (Mel-Skala).
- Die Stärke wird logarithmisch dargestellt, wie auch das Ohr Lautstärke empfindet. Danach wird der Durchschnitt je Frequenzbereich abgezogen. Das macht den Fingerabdruck unabhängig von Mikrofon und Entfernung.
Die Schichten
Das Netzwerk besteht absichtlich nur aus Standardbausteinen, die ESP-DL auf dem Chip beherrscht: Faltung, Normalisierung, Aktivierung (ReLU) und Pooling. Es gibt weder LSTM noch Attention. Die Balkenbreite deutet an, dass die Zahl der Merkmale von Block zu Block wächst.
Das Netzwerk ist klein genug, um auf dem Chip des Geräts in wenigen Zehntelsekunden je Ausschnitt zu laufen.
Wie es lernt
Trainiert wurde mit öffentlichen deutschsprachigen Sprachaufnahmen von mehr als tausend Sprechern, von denen ein Teil nur zum Prüfen diente. Als Lernziel dient ArcFace: Das Netzwerk wird bestraft, wenn Fingerabdrücke derselben Person nicht eng zusammenliegen oder wenn verschiedene Personen nicht mit einem Sicherheitsabstand auseinanderliegen. Dieser Lernteil wird nach dem Training verworfen. Im Gerät steckt nur das kleine Netzwerk.
Danach wird es auf 8-Bit-Zahlen umgerechnet, damit es auf dem Chip schnell läuft. Der Genauigkeitsverlust war im Test kaum messbar.
Wie aus dem Fingerabdruck ein Name wird
Beim Anlernen spricht jede Person einige Sätze. Daraus entsteht ihr Stimmprofil. Im Betrieb wird der Fingerabdruck der aktuellen Äußerung mit allen Profilen verglichen (Kosinus-Ähnlichkeit). Der beste Treffer zählt nur, wenn er über einer einstellbaren Schwelle liegt. Sonst wird „Unbekannt“ gezählt. Kurze und lange Äußerungen werden dafür passend aufbereitet.
Messwerte
| Messung | Ergebnis |
|---|---|
| Fehlerrate (EER) auf Sprechern, die das Netzwerk nie gesehen hat | 4,9 % (ohne Netzwerk etwa 24 %) |
| Trefferquote in einer Runde mit 5 Personen (am PC) | etwa 99 % |
| Rechenzeit auf dem ESP32-P4 | etwa 0,13 Sekunden je 2-Sekunden-Ausschnitt |
Einordnung: Die Testdaten bestehen aus sauberen Vorlese-Aufnahmen. Mit Tischmikrofonen, Raumhall, Abstand und durcheinandersprechenden Personen wird die Erkennung schlechter sein. Wie viel, prüfen wir derzeit mit eigenen Aufnahmen.
Die Richtung mit vier Mikrofonen
Schall braucht für 1 m etwa 2,9 ms. Trifft eine Stimme schräg auf das Gerät, erreicht sie die vier Mikrofone zu minimal verschiedenen Zeiten. Aus diesen Laufzeitunterschieden lässt sich der Winkel berechnen.
Die Mikrofone sitzen nur wenige Zentimeter auseinander. Die Unterschiede sind deshalb winzig, kleiner als ein einzelner Messwert. Die Laufzeit muss darum auf Bruchteile eines Messwerts genau bestimmt werden.
Draufsicht. M1 und M2 sitzen vorne, M4 und M3 hinten.
Schritt für Schritt
1Paare bilden
Aus vier Mikrofonen ergeben sich 6 Paare (4 Seiten, 2 Diagonalen), allgemein N(N−1)/2.
2Laufzeit je Paar (GCC-PHAT)
Von zwei Mikrofonsignalen wird das Kreuzspektrum gebildet und durch seinen Betrag geteilt, sodass nur die Phase übrig bleibt (Phase Transform). Die Rücktransformation ergibt eine Kurve mit einer scharfen Spitze bei der Laufzeit. Das macht das Verfahren unempfindlich gegen Nachhall und unterschiedliche Lautstärken.
Ausgewertet wird nur der Frequenzbereich, in dem Sprache liegt, und die Spitze wird zwischen den Messwerten interpoliert. Die Messung zählt nur in Fenstern, in denen Sprache erkannt wird.
3Winkel finden
Für eine weit entfernte Schallquelle gilt eine ebene Welle. Die Laufzeit eines Paares hängt dann nur vom Winkel θ ab:
pi und pj sind die Mikrofonpositionen. Ein einzelnes Paar liefert zwei mögliche Winkel (θ₁ und θ₂, vorne und hinten gespiegelt). Gesucht wird deshalb der Winkel, bei dem die vorhergesagten Laufzeiten aller sechs Paare am besten zu den gemessenen passen. Dabei gleicht sich auch das Messrauschen aus. Liegt die Stimme höher als die Mikrofone, wird auch das berücksichtigt.
4Ergebnis über 360°
Weil die Mikrofone in der Fläche liegen, ist der Winkel über den ganzen Kreis eindeutig. Mit nur zwei Mikrofonen (frühere Version) zeigt das Gerät deshalb nur den vorderen Halbkreis.
Einmal kalibrieren: Mit einer Stimme von vorne wird festgelegt, welche Mikrofonreihe vorne liegt, damit die Anzeige nicht gespiegelt ist.
Messwerte und Grenzen
| Messung | Ergebnis |
|---|---|
| Kreistest mit Sprache, Gerät in 1 m Abstand | 0° → 0°, 90° → 90°, 180° → 170°, 270° → 264 bis 266° |
Grenzen: Reine Töne eignen sich nicht, weil sich die Phase nicht eindeutig zuordnen lässt. Sprache oder Rauschen funktionieren. Eine laute feste Störquelle nahe an einem Mikrofon (zum Beispiel ein Lüfter) verfälscht die Messung. Sprechen zwei Personen gleichzeitig, zeigt das Gerät meist die lautere. Die Winkel sind Messwerte aus dem Prototyp und noch keine garantierte Genauigkeit.
Rauschen und Musik
Rauschfilter: Das Gerät lernt das Spektrum des Hintergrunds und führt es laufend nach. Steigt der Pegel dauerhaft, etwa wenn Musik einsetzt, passt sich das Profil an. Die Sprachaktivität wird nur in dem Frequenzbereich bewertet, in dem Sprache liegt, damit lauter Bass die Stimme nicht überdeckt. In der Simulation wurde Sprache über Musik erkannt, der Musikanteil nicht.
Takt-Erkennung: Es wird geprüft, ob ein gleichbleibendes Tempo vorliegt, wie bei Musik. Zurzeit wird der Takt nur angezeigt und noch nicht zum Ausblenden genutzt.
Fragen oder Ideen zur Technik?
Der Listener ist ein Prototyp. Die Umfrage zeigt uns, welche Funktionen wichtig sind.
Zur Umfrage